Abstrações são úteis, até deixarem de ser - Os custos implícitos nas implementações de software
Mostrar/Ocultar
Introdução
Boa parte do software que escrevemos depende de detalhes que não queremos carregar o tempo inteiro enquanto desenvolvemos. Quando salvamos um arquivo não pensamos em como os dados serão distribuídos no disco, quando consultamos um banco normalmente não queremos controlar como cada linha será lida e transformada em memória e, quando usamos uma biblioteca, esperamos que ela resolva uma parte do problema sem nos obrigar a conhecer toda a implementação que existe por baixo.
Abstrações tornam isso possível porque permitem trabalhar com uma visão menor de um problema que continua sendo muito maior internamente.
Essa diferença entre o que vemos e o que realmente acontece quase nunca incomoda enquanto o sistema funciona como esperado. Uma chamada pequena pode envolver banco, rede, disco, serialização, cache ou algum comportamento interno de uma biblioteca e ainda assim não existir motivo para conhecer cada uma dessas etapas durante o desenvolvimento normal. A situação muda quando aparece uma lentidão ou uma falha difícil de explicar, porque aquilo que antes era conveniente deixar escondido pode ser exatamente o que precisamos enxergar para entender o problema.

Joel Spolsky descreveu algo parecido em 2002 no texto The Law of Leaky Abstractions, no qual argumenta que abstrações suficientemente complexas acabam deixando características da implementação aparecerem em determinadas situações. Um arquivo remoto pode se comportar quase como um arquivo local até a rede começar a falhar, da mesma forma que SQL permite consultar dados sem conhecer o caminho escolhido pelo banco até uma consulta lenta obrigar alguém a olhar para índices e planos de execução.
A abstração continua sendo útil depois disso, mas já não consegue sozinha explicar o comportamento do sistema.
Quando uma operação simples esconde trabalho demais
ORMs mostram muito bem essa diferença porque transformam acesso a banco em algo bem mais próximo do restante do código da aplicação. Em vez de abrir conexões, montar comandos, percorrer resultados e converter valores manualmente, trabalhamos com objetos e consultas de nível mais alto que removem uma quantidade considerável de código repetitivo. O que aparece no código fica menor, enquanto o banco continua precisando executar todas as operações necessárias para produzir aquele resultado.
Uma consulta que busca pedidos e depois acessa o cliente associado a cada um deles pode parecer simples para quem está lendo o código, mas dependendo da estratégia de carregamento usada pelo ORM ela pode gerar uma consulta inicial seguida de outras consultas para recuperar cada relacionamento. É o conhecido problema N+1, que aparece quando a forma confortável de navegar pelos objetos acaba escondendo várias idas ao banco.
A diferença só fica evidente quando deixamos de observar apenas o código da aplicação e começamos a acompanhar o que realmente foi executado.
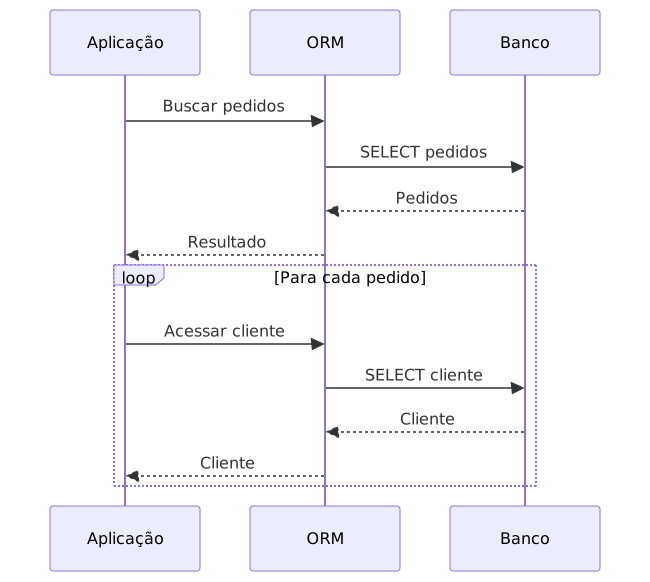
Enquanto essa consulta termina rápido, abrir o SQL gerado provavelmente acrescentaria pouco ao trabalho de quem está desenvolvendo aquela funcionalidade. Se a mesma operação começa a levar segundos, olhar apenas para order.customer deixa de explicar o que está acontecendo e passa a ser necessário descobrir quantas consultas foram executadas, quanto dado voltou do banco e como cada uma delas foi processada.
Não precisamos abandonar o ORM para chegar nesse nível, precisamos apenas conseguir atravessar a abstração quando ela já não mostra informação suficiente.
O mesmo raciocínio aparece em caches, onde uma interface muito pequena pode esconder caminhos bastante diferentes. Enquanto a chave procurada está disponível, a aplicação recebe o dado rapidamente e o sistema que existe atrás do cache praticamente desaparece da operação. Em uma estratégia comum de cache-aside, quando muitas chaves deixam de estar disponíveis ao mesmo tempo, as leituras voltam para o banco ou para algum serviço de origem e uma chamada que continuou igual no código passa a ter um comportamento completamente diferente.
Outras estratégias podem tratar esse caminho de outra forma, mas o custo que estava escondido pelo hit reaparece quando a aplicação precisa consultar a origem.

Uma chamada remota continua sendo uma chamada remota
Clientes e SDKs conseguem esconder boa parte da comunicação entre sistemas e muitas vezes fazem isso tão bem que uma operação remota fica parecida com qualquer outro método usado pela aplicação. Uma chamada como catalog.getProduct(id) pode cuidar de autenticação, protocolo e transformação da resposta sem expor nada disso para quem consome o serviço. Essa interface simplifica bastante a integração, mas não muda o fato de que os dois lados estão separados por uma rede.
Uma chamada dentro do processo pode acessar diretamente objetos que já estão em memória, enquanto uma chamada remota precisa transformar dados em algum formato, transmiti-los, esperar que outro processo faça seu trabalho e trazer a resposta de volta. Timeout, indisponibilidade e falhas de comunicação também passam a fazer parte dessa operação mesmo que nenhuma dessas coisas apareça na assinatura do método.
Quando diferentes nós também mantêm ou replicam estado compartilhado, uma partição de rede pode deixar de ser apenas um problema de comunicação e passar a exigir decisões sobre como preservar consistência e disponibilidade. Esse é um tema que aprofundei em um artigo que escrevi sobre o Teorema CAP, mostrando como essas escolhas aparecem quando uma partição de rede deixa de ser apenas uma possibilidade teórica.

Essa diferença muda até a forma como uma interface deve ser consumida. Fazer várias chamadas pequenas entre objetos no mesmo processo pode ser perfeitamente normal, mas levar esse mesmo desenho para HTTP ou RPC significa fazer várias viagens pela rede e criar novas oportunidades de atraso ou falha.
Em interfaces remotas, costuma fazer sentido reduzir a quantidade de round trips usando operações mais agregadas ou algum tipo de agrupamento, justamente porque uma chamada pela rede não possui o mesmo custo nem as mesmas formas de falha de uma chamada de método no mesmo processo.
Antes de transformar uma fronteira de código em uma fronteira de rede, vale considerar se o problema realmente exige essa separação, algo que discuti em um artigo que escrevi sobre como projetar um monólito escalável sem abrir mão de isolamento e organização interna.
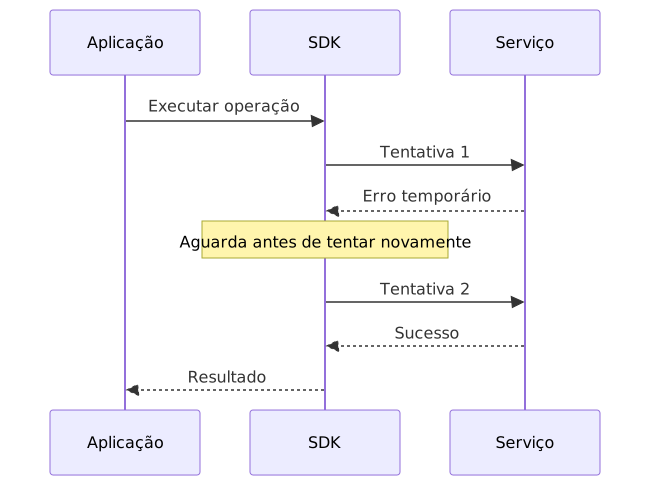
SDKs podem esconder ainda mais trabalho ao cuidar de aspectos como autenticação ou renovação de credenciais, e alguns também aplicam retries automaticamente para determinados erros. Esse comportamento varia entre bibliotecas e configurações, mas significa que uma operação visível apenas uma vez no código pode chegar várias vezes ao serviço remoto quando uma política de retry está ativa. Em sistemas com várias instâncias isso pode se ampliar quando todas repetem a operação ao mesmo tempo.
Eu escrevi um artigo específico sobre esse comportamento em Retries Distribuídos: Evitando o Thundering Herd, porque durante uma investigação de latência ou aumento de tráfego essas tentativas deixam de ser detalhe e passam a fazer parte da explicação.
Abstrações internas também precisam justificar seu custo
Nem toda abstração vem de um framework ou de uma biblioteca externa. Também criamos services, repositories, adapters e outras estruturas para organizar responsabilidades, concentrar decisões e impedir que determinadas partes do sistema conheçam detalhes que não deveriam conhecer.
O problema começa quando essas camadas passam a existir apenas porque fazem parte do desenho adotado e uma operação precisa atravessar vários arquivos antes de chegar ao lugar onde alguma coisa realmente acontece, mesmo que cada um deles apenas receba dados, repasse a execução e devolva o resultado sem acrescentar nenhuma decisão relevante.
O custo computacional dessas chamadas normalmente é pequeno, mas o custo para entender o código aumenta conforme cresce a distância entre a operação que está sendo lida e a implementação que realmente produz algum efeito. Quando acompanhar uma requisição exige passar por controller, service, use case, repository e adapter apenas para descobrir que boa parte dessas estruturas encaminha a mesma chamada para a próxima, a abstração que deveria esconder complexidade começa a criar uma complexidade própria.
Esse tipo de dependência indireta aparece também em um artigo que escrevi sobre acoplamento oculto, justamente porque nem todo acoplamento fica evidente quando observamos apenas o desenho geral da arquitetura.
A quantidade de camadas, porém, não determina sozinha se existe abstração demais, porque uma aplicação pode ter várias fronteiras e ainda assim cada uma delas proteger algo que realmente precisa permanecer isolado. Um exemplo comum aparece quando usamos uma biblioteca externa cujos tipos, configurações, modelos de erro e decisões de API não queremos espalhar pelo restante do sistema.
Nesse caso, adicionar uma interface própria e um adapter pode ser exatamente o custo necessário para manter aquela dependência concentrada em um único ponto, permitindo que o restante da aplicação trabalhe com conceitos definidos de acordo com suas próprias necessidades em vez de incorporar diretamente o modelo escolhido pelo fornecedor.

Esse isolamento se torna especialmente útil quando a dependência muda, porque uma atualização incompatível, a substituição por outra implementação ou uma alteração na forma como erros, resultados e configurações são representados pode ficar restrita ao adapter em vez de atingir todos os lugares que importaram diretamente os tipos da biblioteca.
O mesmo raciocínio vale para APIs externas e sistemas legados cujos modelos não representam bem os conceitos usados internamente, já que a camada criada entre os dois lados pode traduzir essas diferenças e impedir que decisões tomadas fora da aplicação passem a orientar a estrutura do domínio apenas porque estavam presentes na integração.
Isso é diferente de criar um wrapper somente porque uma biblioteca talvez seja substituída algum dia. Quando a aplicação utiliza uma API pequena e estável, não precisa esconder seus tipos e não possui nenhuma razão concreta para impedir que aquela dependência apareça em outros pontos, reproduzir todos os métodos em uma interface própria pode apenas duplicar a API original e criar mais uma estrutura para manter.
Se uma camada criada para isolar uma biblioteca continua expondo os mesmos tipos, as mesmas operações e os mesmos conceitos do fornecedor, o isolamento pretendido praticamente não aconteceu e a equipe passa a manter duas interfaces para acessar o mesmo comportamento.
Repositories genéricos baseados apenas em operações CRUD mostram outra versão desse problema quando são introduzidos porque o desenho adotado pressupõe que o acesso aos dados precisa passar por uma interface uniforme. Operações como Get, Save, Update e Delete podem representar bem algumas necessidades, mas começam a exigir novos métodos, exceções e caminhos alternativos quando surgem agregações, paginação específica, controle de concorrência ou consultas que dependem de capacidades próprias do banco.
Se o repository está protegendo uma fronteira importante ou concentrando decisões que não queremos espalhar pelo sistema, essa abstração pode continuar fazendo sentido mesmo quando precisa evoluir, mas preservar uma camada genérica apenas para manter uma separação que já não protege nada relevante transforma a própria generalização em uma limitação.
A diferença acaba estando menos na quantidade de classes e mais no problema que cada fronteira resolve. Uma camada que concentra uma dependência externa, traduz modelos incompatíveis, impede que tipos de uma biblioteca se espalhem pela aplicação ou protege uma parte importante do sistema contra mudanças possui uma razão concreta para existir e pode justificar tranquilamente a indireção que adiciona.
Quando a camada apenas encaminha chamadas porque a arquitetura pressupõe que toda operação deve passar por determinada sequência de interfaces, sem isolar uma mudança, traduzir um modelo ou concentrar alguma decisão, o custo continua presente sem resolver um problema concreto em troca.
Esconder não é o mesmo que tornar invisível
Uma abstração ajuda quando deixa detalhes fora do caminho normal e ainda permite encontrá-los quando isso passa a ser necessário. Não precisamos observar o SQL de cada consulta enquanto desenvolvemos uma tela, mas precisamos conseguir descobrir quais queries foram executadas se o banco começar a dominar o tempo de resposta. Também não precisamos acompanhar cada chamada de rede durante todo o desenvolvimento, mas métricas e tracing precisam permitir reconstruir esse caminho quando uma requisição começa a demorar mais do que deveria.
Filas deixam essa diferença ainda mais clara porque uma API simples de publicação pode esconder backlog, tempo de espera, redeliveries e consumidores que já não acompanham a taxa de produção. Publicar e processar uma mensagem são etapas separadas, e a confirmação recebida pelo produtor depende das garantias oferecidas pelo broker, pelo protocolo e pela configuração adotada, sem significar necessariamente que o processamento já aconteceu.
Quando produtor e consumidor operam em velocidades muito diferentes, desacoplar a execução não elimina a necessidade de observar a fila nem de controlar a pressão exercida sobre quem consome. Eu tratei desse ponto em outro artigo que escrevi sobre backpressure e controle de fluxo, mostrando por que uma fila por si só não resolve o desequilíbrio entre quem produz e quem consegue processar.
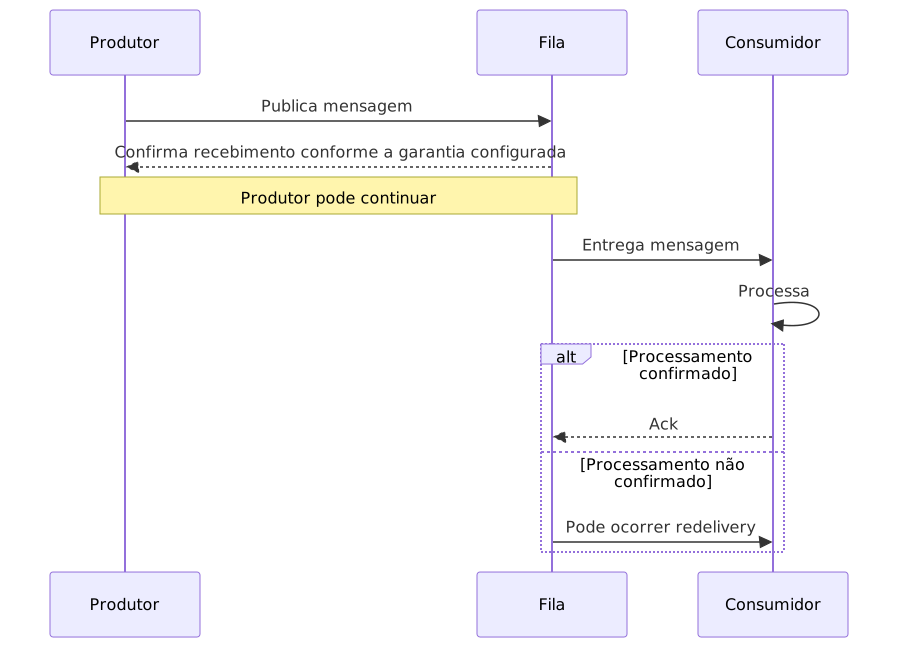
Caches, filas, bancos e serviços remotos podem permanecer atrás de interfaces menores durante grande parte da vida da aplicação sem que isso seja um problema. A diferença aparece quando perdemos a capacidade de observar o que acontece depois dessas interfaces, porque nesse momento a abstração deixa de apenas esconder detalhes e começa a esconder o próprio comportamento do sistema.
Trade-offs: quando a abstração vale o custo
Nem todo custo introduzido por uma abstração é desperdício. Uma fila adiciona infraestrutura e pode aumentar o tempo entre produzir e processar uma mensagem, mas também reduz a dependência síncrona do produtor em relação à velocidade ou à disponibilidade do consumidor. Um cache traz invalidação e consistência para a discussão, mas pode reduzir bastante a pressão sobre uma origem cara.
Separar um componente em outro serviço cria rede, observabilidade e novas formas de falha, embora essa fronteira possa ser necessária quando existe isolamento, escala ou evolução independente que realmente importa para o sistema.
O mesmo acontece em níveis menores. Um ORM pode continuar economizando muito trabalho mesmo que algumas consultas precisem de tratamento específico, enquanto um SDK pode esconder uma integração difícil e ainda exigir que suas políticas de retry sejam conhecidas durante um incidente. A abstração continua valendo a pena quando o custo que ela adiciona compra alguma propriedade que seria mais cara de reconstruir em cada ponto da aplicação.
Essa troca também aparece na infraestrutura, onde decisões envolvendo self-hosting, plataformas gerenciadas, Kubernetes ou serviços serverless alteram quais responsabilidades continuam com o time e quais são absorvidas por uma plataforma ou provedor.
Eu escrevi sobre essa escolha em Self-Hosting é para o seu projeto? e também explorei o outro lado em O Custo Invisível do Serverless, porque uma abstração pode remover bastante trabalho operacional e ainda introduzir dependências, limites e custos que precisam ser considerados antes de assumir que a opção mais abstrata será também a mais simples.

Remover uma camada também tem preço porque detalhes que estavam concentrados em um único lugar podem voltar a se espalhar pelo sistema, junto com código repetido e decisões que passam a ser tomadas de maneiras diferentes. O trade-off não está entre ter custo e não ter custo, está entre escolher onde essa complexidade ficará e qual problema queremos deixar de resolver toda vez que uma nova funcionalidade for criada.
Quando ela deixa de valer o custo
O desgaste costuma aparecer menos pela quantidade de abstrações e mais pelo comportamento que elas passam a exigir da equipe. Contar interfaces, services ou repositories diz pouco sobre a qualidade do desenho se não entendermos o que cada uma dessas estruturas ainda está conseguindo proteger, concentrar ou simplificar.
Um sinal forte aparece quando a equipe passa a contornar a abstração continuamente, quando recursos naturais da tecnologia precisam ser deformados para caber em uma interface ou quando acompanhar uma operação significa atravessar várias camadas que já não tomam decisão alguma. Outro aparece quando detalhes que deveriam estar concentrados começam a escapar por caminhos paralelos, obrigando o código a conhecer ao mesmo tempo a abstração e aquilo que ela deveria esconder.
Nesses casos, revisar a camada deixa de ser uma discussão sobre quantidade de interfaces e passa a ser uma tentativa de recuperar a propriedade que justificava sua existência ou admitir que ela já não entrega o mesmo benefício.
Conclusão
Abstrações continuam sendo uma das principais formas de controlar a complexidade porque permitem trabalhar com partes do sistema sem precisar carregar o tempo inteiro tudo o que existe por baixo delas, seja banco, rede, disco, mensageria ou qualquer outro detalhe que pouco acrescenta ao problema sendo resolvido naquele momento.
Esse isolamento é justamente o que torna uma abstração valiosa, mas ele precisa continuar permitindo que esses detalhes sejam encontrados quando voltam a importar, como acontece quando uma consulta começa a degradar, uma integração apresenta falhas ou uma camada já não representa tão bem o comportamento que deveria esconder.
Remover abstrações apenas para deixar o código mais direto também não resolve essa equação, já que muitas delas concentram decisões que de outra forma acabariam espalhadas pelo sistema e evitam que cada parte da aplicação precise resolver novamente os mesmos problemas.
A revisão passa a fazer sentido quando essa relação se inverte e a camada começa a exigir mais esforço para ser mantida do que o trabalho que consegue evitar, seja criando caminhos desnecessariamente longos, escondendo custos que já são relevantes ou obrigando a equipe a contornar a própria abstração para conseguir usar os recursos que existem abaixo dela, algo que deixa de ser uma preferência sobre estilo de arquitetura e passa a fazer parte da evolução normal do software.
Referências
- Joel Spolsky - The Law of Leaky Abstractions
- Martin Fowler - Microservices and the First Law of Distributed Objects
- Hibernate ORM User Guide - fetching / N+1 problem
- AWS SDK Reference - retry behavior
- Alistair Cockburn - Hexagonal Architecture / Ports and Adapters
- Martin Fowler - Gateway
- Martin Fowler - Repository
- Eric Evans - Domain-Driven Design Reference
- Microsoft Azure Architecture Center - Anti-Corruption Layer Pattern
- RabbitMQ - Consumer Acknowledgements and Publisher Confirms
Artigos recomendados
Reduzindo mais de 90% da latência na Rinha de Backend 2026 executando FAISS diretamente dentro das APIs .NET
Como remover o processo Python e integrar o FAISS diretamente em APIs .NET Native AOT reduz a latência de 112ms para 10ms na Rinha de Backend 2026.
5 min de leitura
Desafio de Performance - Rinha de Backend 2026 - Insights da Minha Versão em C# AOT + Similarity Search em Python com FAISS
Como cheguei a uma solução viável para a Rinha de Backend 2026 usando .NET 10 AOT e FAISS dentro do limite de 1 vCPU e 350 MB.
15 min de leitura
O Acoplamento Oculto: Como dependências sutis quebram a manutenção de um software
Entenda como dependências invisíveis corroem a arquitetura de software, explorando desde fundamentos até casos avançados em sistemas .NET.
8 min de leitura