Timeouts e Deadlines - Como tratar latência como um orçamento em sistemas distribuídos
Mostrar/Ocultar
Introdução
Quando uma integração pode demorar demais, a reação mais comum é adicionar um timeout, então a chamada ao banco recebe 5 segundos, o cliente HTTP recebe 10 e a operação externa ganha mais algumas tentativas antes de falhar. Cada limite parece razoável quando observado isoladamente, embora a requisição do usuário não enxergue essas etapas separadamente e perceba apenas o tempo total.
Esse detalhe muda o problema porque, se uma API promete responder em até 2 segundos, não adianta permitir que cada dependência espere 2 segundos nem reiniciar essa contagem sempre que a requisição atravessa outro serviço. O tempo já consumido precisa ser descontado e o restante precisa acompanhar a operação até o último componente capaz de fazer trabalho em seu nome.
É essa a diferença prática entre configurar timeouts locais e tratar latência como um orçamento ponta a ponta.

Um orçamento bem propagado não garante que o sistema responderá dentro do limite, mas impede que cada camada aja como se tivesse recebido um tempo novo e permite interromper trabalho cuja resposta já não chegará ao solicitante, preservando conexões, threads, memória e capacidade para requisições que ainda podem terminar com sucesso.
Timeout e deadline não são a mesma coisa
Os dois conceitos limitam tempo, mas representam informações diferentes.
- Timeout é uma duração máxima local e uma chamada iniciada agora pode aguardar, por exemplo, 500 milissegundos.
- Deadline é o instante limite até o qual o solicitante está disposto a esperar pela resposta daquela operação.
Um timeout pode ser convertido em deadline somando a duração ao instante em que a operação começa, mas o problema aparece quando diferentes componentes repetem essa conversão sem considerar o tempo já gasto.
Imagine uma requisição com limite total de 2 segundos na qual a API passa 700 ms validando e consultando dados antes de chamar outro serviço. Se a nova chamada receber um timeout fixo de 2 segundos, o sistema terá transformado o limite original em até 2,7 segundos e o tempo total continuará crescendo a cada salto se o próximo serviço fizer o mesmo.
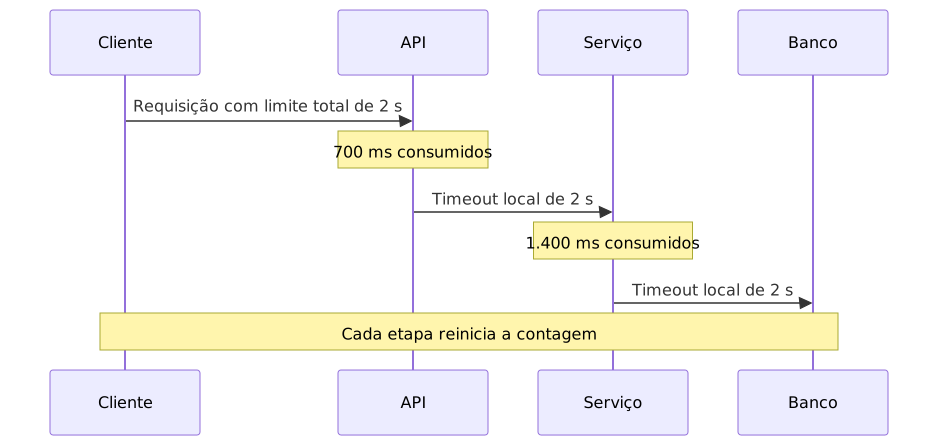
Com deadline, todos conhecem o mesmo ponto final e se 700 ms já foram usados, restam no máximo 1,3 segundo para as próximas etapas, descontando ainda uma margem para serialização, trânsito de rede e montagem da resposta.
A documentação do gRPC descreve exatamente esse comportamento ao explicar que o tempo já decorrido é deduzido antes da próxima chamada quando uma deadline é propagada, enquanto a conversão para uma duração restante evita depender de relógios perfeitamente sincronizados entre máquinas.
Essa propagação não acontece automaticamente em toda integração. O gRPC possui suporte explícito a deadlines, mas o comportamento depende da implementação e no .NET pode ser habilitado entre serviços com EnableCallContextPropagation(). Em uma integração HTTP convencional, repassar um CancellationToken ao HttpClient permite cancelar a espera local, mas não comunica por si só quanto tempo resta ao servidor remoto, por isso o orçamento precisa de um contrato explícito entre os serviços ou de suporte equivalente na infraestrutura.
O custo do trabalho que chega tarde
Quando o cliente deixa de esperar, o servidor não necessariamente para, por isso uma consulta pode continuar ocupando uma conexão, uma chamada HTTP pode permanecer em andamento e uma tarefa intensiva pode seguir consumindo CPU mesmo que sua resposta já não possa ser entregue.
Esse trabalho tardio é particularmente perigoso durante uma degradação porque, conforme as respostas ficam mais lentas, mais operações permanecem simultaneamente em andamento, consomem memória e mantêm recursos ocupados por mais tempo, reduzindo a capacidade disponível até que os clientes atinjam seus timeouts e tentem novamente, adicionando carga a um sistema que já estava sobrecarregado.

O capítulo sobre falhas em cascata do livro Site Reliability Engineering chama atenção para esse padrão no qual servidores sobrecarregados gastam recursos processando requisições que já excederam a deadline de seus clientes e produzem resultados sem valor enquanto competem com operações que ainda poderiam ser concluídas.
Timeout não serve apenas para evitar que uma pessoa espere indefinidamente e pode funcionar também como um mecanismo de contenção de recursos, desde que o cancelamento chegue ao trabalho que precisa ser interrompido.
Cancelar a espera não é cancelar o trabalho
Existe uma diferença importante entre o cliente parar de aguardar e toda a árvore de execução realmente parar, já que fechar uma conexão ou lançar uma exceção no primeiro serviço não interrompe automaticamente consultas, chamadas e tarefas iniciadas abaixo dele.
O cancelamento precisa ser cooperativo porque cada camada deve receber o sinal, repassá-lo e usar APIs capazes de observá-lo. No ASP.NET Core, o HttpContext.RequestAborted informa que a requisição foi encerrada e no gRPC o servidor recebe um CancellationToken no contexto da chamada, que precisa chegar ao acesso a dados, ao cliente HTTP e a qualquer processamento assíncrono iniciado para produzir a resposta.
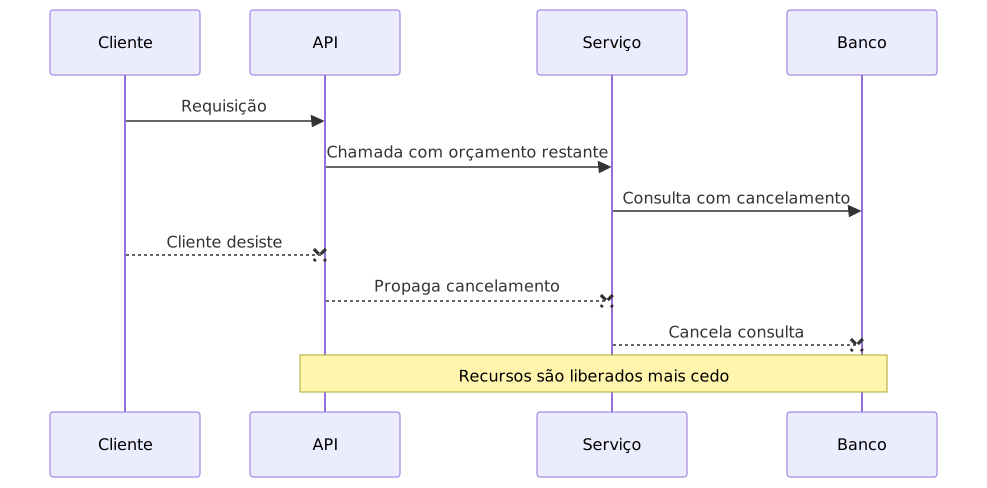
Em .NET, um limite pode ser aplicado ao endpoint com o middleware de request timeouts do ASP.NET Core e o token resultante pode ser propagado para as operações internas:
using Microsoft.AspNetCore.Http.Timeouts;

var builder = WebApplication.CreateBuilder(args);

builder.Services.AddRequestTimeouts(options =>
{
    options.AddPolicy("operation-budget", new RequestTimeoutPolicy
    {
        Timeout = TimeSpan.FromMilliseconds(1_800),
        TimeoutStatusCode = StatusCodes.Status503ServiceUnavailable
    });
});

var app = builder.Build();
app.UseRequestTimeouts();

app.MapGet("/orders/{id:guid}", async (
    Guid id,
    OrderService orders,
    CancellationToken cancellationToken) =>
{
    var order = await orders.GetAsync(id, cancellationToken);
    return order is null ? Results.NotFound() : Results.Ok(order);
})
.WithRequestTimeout("operation-budget");
O token recebido deve continuar sendo propagado:
public async Task<Order?> GetAsync(
    Guid id,
    CancellationToken cancellationToken)
{
    var order = await db.Orders
        .SingleOrDefaultAsync(x => x.Id == id, cancellationToken);

    if (order is null)
        return null;

    order.FraudRisk = await fraudClient.GetRiskAsync(
        order.CustomerId,
        cancellationToken);

    return order;
}
O status 503 usado no exemplo é uma decisão explícita do contrato dessa API e não uma regra geral para qualquer timeout. O middleware do ASP.NET Core usa 504 como padrão e permite configurar outro status, enquanto a semântica definida pela RFC 9110 reserva 504 Gateway Timeout para o servidor que atua como gateway ou proxy e não recebe a tempo a resposta de um upstream.
O token também não torna o cancelamento instantâneo nem garante que toda tecnologia conseguirá abortar uma operação em qualquer ponto, pois ele representa uma solicitação cooperativa de interrupção que a implementação precisa observar e tratar de forma segura. A própria documentação da Microsoft sobre cancelamento no .NET deixa essa responsabilidade com cada operação, enquanto a documentação sobre RequestAborted recomenda repassar o token a operações longas como consultas ao banco e chamadas HTTP.
Deadline não desfaz efeitos colaterais
Interromper uma espera também não significa desfazer o que já aconteceu porque uma cobrança pode ter sido autorizada, uma mensagem pode ter sido publicada ou uma transação pode ter sido confirmada imediatamente antes de a resposta se perder.
Do ponto de vista do cliente, o resultado se torna desconhecido porque ele sabe que não recebeu confirmação dentro do prazo, mas não sabe se a operação falhou antes ou depois de produzir o efeito e repetir a chamada sem proteção pode duplicar a ação.
Por isso, operações com efeitos colaterais precisam combinar limites de tempo com estratégias como:
- Chaves de idempotência para reconhecer repetições da mesma intenção.
- Identificadores estáveis de operação para consultar o resultado posteriormente.
- Transações e restrições de unicidade onde elas realmente protegem a regra.
- Estados explícitos como pendente, concluído e desconhecido.
- Compensação quando não for possível tornar a ação naturalmente idempotente.
A discussão da Amazon sobre APIs idempotentes parte desse mesmo problema porque retries são úteis contra falhas transitórias, mas precisam evitar que uma repetição crie efeitos adicionais.
Uma deadline define até quando vale esperar pela resposta sem funcionar como uma transação distribuída nem apagar efeitos produzidos antes de expirar.
Como dividir um orçamento de latência
O orçamento de uma operação deve nascer do tempo que o cliente está disposto a esperar e do contrato do produto, usando o SLO de latência como uma referência para entender o comportamento esperado do serviço e não como se ele fosse a deadline de cada requisição.
Essa diferença importa porque o SLO normalmente descreve uma distribuição agregada durante uma janela, como 99% das requisições concluídas abaixo de determinado limite, enquanto a deadline determina quanto uma chamada específica ainda pode esperar. Um serviço pode cumprir seu SLO mesmo que uma pequena parcela das requisições ultrapasse aquele valor, mas cada operação continua precisando de um limite próprio para impedir consumo indefinido de recursos.
Se uma operação precisa responder em até 2 segundos, uma divisão inicial poderia reservar o tempo da seguinte forma:
| Etapa | Orçamento inicial |
|---|---|
| Entrada, autenticação e validação | 150 ms |
| Consulta principal | 600 ms |
| Serviço externo | 700 ms |
| Transformação e serialização | 200 ms |
| Margem para rede e variação | 350 ms |
| Total | 2.000 ms |
Esses valores não deveriam nascer apenas de preferência pessoal porque distribuições de latência em produção, testes de carga e o custo de cada caminho ajudam a descobrir quanto tempo uma etapa realmente precisa, enquanto percentis como p95 e p99 mostram o comportamento das requisições lentas com mais clareza do que as médias que escondem as caudas.
O orçamento também não precisa virar uma sequência rígida de fatias que sempre somam o limite porque em chamadas paralelas as durações não se somam da mesma forma, embora todas consumam recursos e compartilhem o mesmo ponto final. Na prática, cada dependência pode receber o menor valor entre:
- O tempo restante da operação, descontada uma margem para responder.
- O limite máximo aceitável para aquela dependência.
- O tempo que ainda permite executar um fallback útil.
timeout_da_dependencia = min(
    deadline - agora - reserva_para_resposta,
    limite_local_da_dependencia
)
Se o resultado for zero ou negativo, iniciar outra chamada apenas produzirá trabalho que já nasceu atrasado, então, dependendo da operação, pode ser melhor falhar rapidamente, devolver uma resposta degradada ou usar um dado em cache.
Também é importante limitar deadlines recebidas externamente para que um cliente não consiga manter recursos internos ocupados por vários minutos apenas enviando um prazo arbitrariamente longo, o que pode ser evitado fazendo o serviço respeitar o menor valor entre a deadline recebida e seu próprio limite operacional.
Retries precisam caber no mesmo orçamento
Retry não cria tempo porque cada nova tentativa consome parte do mesmo orçamento usado pela tentativa anterior e pelo intervalo de backoff, por isso, entregar novamente o timeout completo a cada uma delas pode fazer uma política criada para aumentar a resiliência multiplicar a latência máxima e o volume de trabalho.
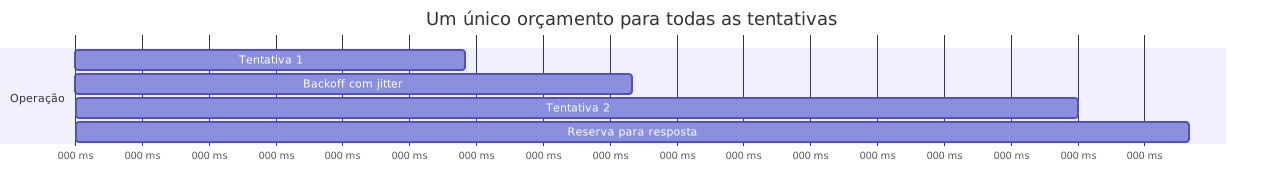
Antes de repetir, o cliente precisa avaliar se ainda existe tempo para:
- Aguardar o backoff.
- Executar outra tentativa com chance realista de sucesso.
- Processar a resposta.
- Devolvê-la antes da deadline.
Quando o orçamento restante já não comporta esse ciclo, o retry apenas aumenta a carga. A documentação da Microsoft sobre deadlines e cancelamento no gRPC para .NET informa que a deadline acompanha todas as tentativas de uma chamada e interrompe as restantes quando é excedida.
Backoff exponencial e jitter continuam importantes para evitar tentativas sincronizadas como mostrei em Retries Distribuídos: Evitando o Thundering Herd, mas a espera também precisa caber no orçamento original. A Amazon Builders’ Library trata timeout, retry, backoff e jitter como decisões relacionadas justamente porque uma política altera o efeito das outras.
Trabalho síncrono e assíncrono possuem contratos diferentes
Nem toda operação deve terminar dentro da duração de uma requisição HTTP porque relatórios extensos, processamento de vídeo e importações podem ser melhor representados como workflows assíncronos nos quais a API aceita o trabalho, devolve um identificador e permite acompanhar seu estado.
Nesse caso, a deadline da requisição de entrada limita apenas o aceite e a persistência segura do comando, enquanto o processamento posterior precisa de outro contrato com prazo próprio, políticas de expiração e uma definição clara do que fazer quando o resultado deixa de ter valor para o negócio.
Propagar cegamente o cancelamento da conexão para uma tarefa já aceita pode ser errado quando o comando foi persistido de forma durável e o contrato da aplicação assumiu o compromisso de continuar o processamento, pois nesse cenário o fechamento da conexão do cliente não deveria apagar o trabalho. O status 202 Accepted sozinho não oferece essa garantia e apenas informa que a requisição foi aceita sem concluir o processamento, que ainda pode falhar ou nem chegar a acontecer segundo a RFC 9110. Por outro lado, colocar uma mensagem em uma fila sem informar até quando ela continua útil permite que um consumidor processe dados vencidos horas depois.

Separar esses contratos evita confundir o tempo de uma conexão com o ciclo de vida de um processo de negócio.
Observabilidade: descobrir onde o orçamento desapareceu
Uma métrica única de duração total mostra que existe um problema, mas não explica onde o tempo foi consumido e por isso o tracing distribuído é necessário para acompanhar a mesma operação pelos serviços e comparar o tempo gasto em filas, consultas, chamadas externas, retries e processamento local.
Algumas informações são especialmente úteis:
- Deadline original e orçamento restante ao entrar em cada serviço.
- Duração de cada tentativa e tempo gasto em backoff.
- Quantidade de operações canceladas pelo cliente.
- Timeouts internos e timeouts de dependências, separados por causa.
- Respostas concluídas depois de o solicitante desistir.
- Tempo em fila antes do início do processamento.
- Percentis de latência por rota e dependência.
Nem todo OperationCanceledException representa a mesma situação porque o usuário pode ter fechado a conexão, a deadline da operação pode ter acabado ou uma política interna mais curta pode ter protegido uma dependência. Registrar essas causas separadamente evita tratar um comportamento esperado como falha desconhecida e também revela quando um limite está agressivo demais.
Os spans devem compartilhar o mesmo contexto de trace para que uma tentativa tardia ou uma consulta cancelada possam ser relacionadas à requisição que as originou. Nas convenções de gRPC do OpenTelemetry, DEADLINE_EXCEEDED pode aparecer em rpc.response.status_code e também em error.type quando representa uma falha, permitindo registrar o resultado com uma semântica conhecida pelas ferramentas de telemetria.
Valores exatos como a deadline original e o orçamento restante podem ser registrados em spans ou logs quando forem necessários para uma investigação, mas não deveriam virar labels de métricas porque sua alta cardinalidade tornaria a telemetria mais cara e difícil de operar. Para métricas, histogramas de orçamento restante e contadores agregados por causa do cancelamento costumam representar melhor esse comportamento.
Armadilhas comuns
Usar o mesmo timeout para todas as dependências
Uma leitura em cache, uma consulta analítica e uma cobrança externa possuem distribuições de latência e consequências diferentes, portanto o limite deve considerar o comportamento da dependência e o valor da operação sem deixar de respeitar o orçamento ponta a ponta.
Configurar limites muito altos para evitar erros
Aumentar o timeout pode esconder uma degradação e ampliar o número de operações simultâneas porque, embora o sistema pareça falhar menos durante um período, ele passa a reter recursos por mais tempo e pode transformar uma lentidão localizada em sobrecarga geral.
Configurar limites curtos sem observar percentis
Um limite arbitrariamente baixo pode fazer requisições legítimas falharem de forma sistemática em caminhos menos frequentes e mais caros, por isso a deadline precisa ser validada com tráfego representativo e testes de carga.
Criar várias fontes de timeout sem distinguir a causa
HttpClient.Timeout, um CancellationTokenSource local, a deadline recebida e o proxy podem encerrar a operação em momentos diferentes e a documentação de HttpClient.Timeout observa que o menor limite prevalece quando ele é combinado com um token por requisição, o que torna difícil diagnosticar qual deles venceu sem uma estratégia clara.
Receber o token e não repassá-lo
Adicionar CancellationToken apenas à assinatura do endpoint não libera recursos se as operações internas o ignorarem porque a propagação precisa chegar até as APIs que realizam o trabalho.
Tratar cancelamento como rollback
Uma operação cancelada pode ter produzido efeitos e repeti-la exige idempotência ou reconciliação em vez de apenas uma nova tentativa.
Um caminho prático para adoção
Não é necessário redesenhar todos os serviços ao mesmo tempo porque a adoção pode começar pelos caminhos mais críticos:
- Defina o limite ponta a ponta a partir do contrato do produto e da tolerância do cliente, usando o SLO de latência como referência.
- Meça a distribuição atual de latência e identifique onde o tempo é consumido.
- Propague cancelamento da entrada até banco, HTTP, gRPC e processamento assíncrono relacionado.
- Faça chamadas filhas respeitarem o tempo restante, com limites locais menores quando necessário.
- Garanta que retries e backoff compartilhem a deadline original.
- Proteja efeitos colaterais com idempotência e estados recuperáveis.
- Diferencie cancelamento do cliente, deadline excedida e timeout de dependência na telemetria.
- Teste sob lentidão e sobrecarga, não apenas no caminho de sucesso.
O objetivo não é encontrar um número perfeito e permanente, já que os orçamentos precisam evoluir conforme mudam o tráfego, as dependências e as expectativas do produto.
Conclusão
Timeouts locais são necessários, mas não representam sozinhos o tempo que uma operação inteira pode consumir porque, quando cada camada reinicia a contagem, a latência máxima cresce silenciosamente e o sistema continua trabalhando mesmo depois de o resultado perder o valor.
Deadlines transformam esse conjunto de limites independentes em um orçamento comum no qual o tempo gasto em uma etapa deixa menos tempo para a próxima, retries precisam caber no restante e componentes podem evitar trabalho que já começaria atrasado.
Para que isso funcione, o limite precisa ser propagado junto com o cancelamento, observado pelas operações internas e acompanhado por telemetria capaz de explicar onde o orçamento terminou, enquanto idempotência e reconciliação continuam indispensáveis quando existem efeitos colaterais porque desistir de esperar não significa desfazer o que já foi executado.
Tratar latência como orçamento não elimina dependências lentas nem garante o cumprimento do SLO de latência, mas torna explícita uma restrição que sempre existiu e permite que o sistema use sua capacidade onde ainda existe chance de produzir uma resposta útil.
Referências
- gRPC - Deadlines
- gRPC - Cancellation
- Google SRE - Addressing Cascading Failures
- Google SRE - Handling Overload
- Google SRE - Service Level Objectives
- Amazon Builders’ Library - Timeouts, retries, and backoff with jitter
- Amazon Builders’ Library - Making retries safe with idempotent APIs
- RFC 9110 - HTTP Semantics
- Microsoft Learn - Reliable gRPC services with deadlines and cancellation
- Microsoft Learn - Request timeouts middleware in ASP.NET Core
- Microsoft Learn - Use HttpContext in ASP.NET Core
- Microsoft Learn - Cancellation in managed threads
- Microsoft Learn - HttpClient.Timeout
- OpenTelemetry - Semantic conventions for gRPC
Artigos recomendados
Abstrações são úteis, até deixarem de ser - Os custos implícitos nas implementações de software
Abstrações simplificam o desenvolvimento, mas podem esconder custos, comportamentos e falhas que voltam a importar quando o sistema cresce ou começa a apresentar problemas.
14 min de leitura
Reduzindo mais de 90% da latência na Rinha de Backend 2026 executando FAISS diretamente dentro das APIs .NET
Como remover o processo Python e integrar o FAISS diretamente em APIs .NET Native AOT reduz a latência de 112ms para 10ms na Rinha de Backend 2026.
5 min de leitura
Desafio de Performance - Rinha de Backend 2026 - Insights da Minha Versão em C# AOT + Similarity Search em Python com FAISS
Como cheguei a uma solução viável para a Rinha de Backend 2026 usando .NET 10 AOT e FAISS dentro do limite de 1 vCPU e 350 MB.
15 min de leitura